CASE STUDY
Desarrollo de un sistema de búsqueda RAG de nueva generación
Un diseño 『RAG 2.0』 que combina búsqueda híbrida, reranker y orquestación con estado. Construido sobre LlamaIndex + Qdrant + bge-m3, un enfoque que apunta a la precisión y operabilidad que la búsqueda de un solo paso no alcanza.
Por qué 『RAG 2.0』, y por qué ahora
Entre los proyectos que incorporan IA generativa al ámbito empresarial, la consulta más frecuente hoy es “queremos poder buscar en nuestros documentos internos”. Sin embargo, en el último año ha quedado ampliamente claro que un RAG ingenuo —simplemente volcar todo en una base vectorial y hacer búsqueda por similitud— no llega a una precisión utilizable en producción.
La razón es sencilla: la cercanía semántica y la respuesta correcta desde el punto de vista del negocio son cosas distintas. Si preguntas “¿cuál es la política interna sobre la fecha de pago de facturas?”, lo que sube en el ranking de similitud vectorial suelen ser actas de reunión variadas que contienen “pago” o “fecha”. Lo que realmente quieres es una cláusula concreta del manual de políticas.
Cubrir esa brecha es lo que se llama RAG 2.0: búsqueda híbrida, reranking, descomposición de consultas y orquestación con estado. Combinándolas, las moldeamos hasta convertirlas en una experiencia de búsqueda que aguanta en producción.
Visión general del enfoque de desarrollo
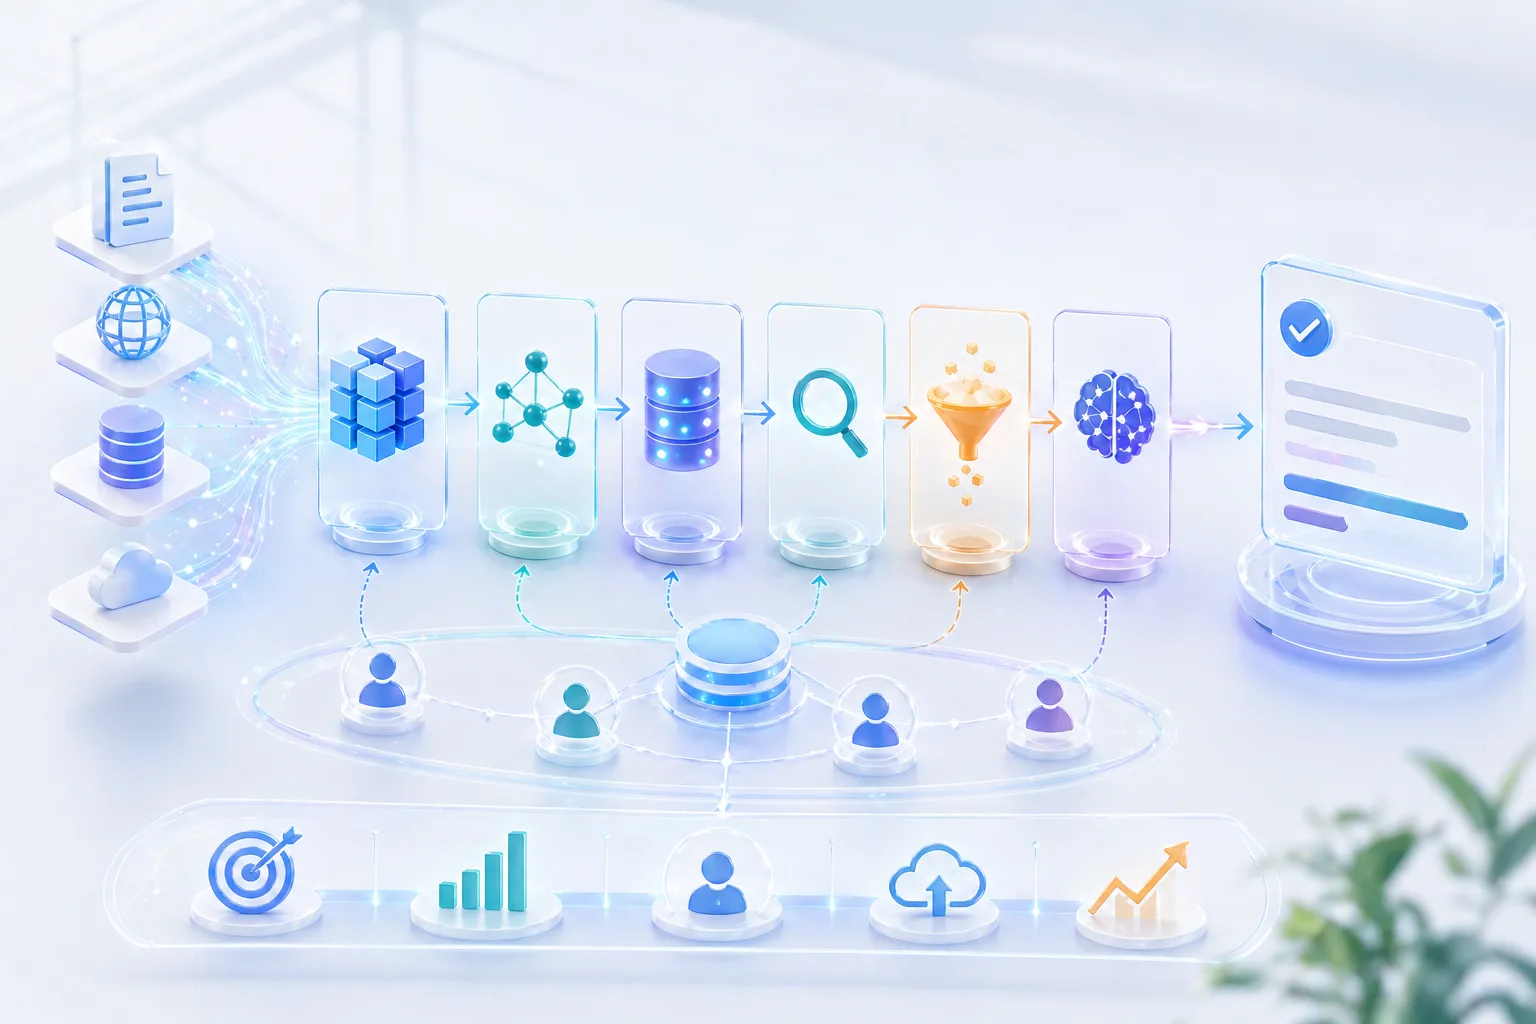
El RAG que construimos no es un único “buscar → responder”. Lo diseñamos como un flujo de búsqueda con estado: descomponer la consulta, reunir un primer conjunto mediante búsqueda híbrida, reordenar con un reranker y, si hace falta, volver a buscar. La base es LlamaIndex + Qdrant; para los embeddings combinamos OpenAI Embeddings y bge-m3 según el caso, y situamos modelos de la familia GPT en el centro de la generación. El alcance estándar es del orden de 4 semanas para llevarlo desde la PoC hasta un estado verificable.
Estrategia de retrieval — el corazón de 『RAG 2.0』
Nuestra postura es que la búsqueda vectorial pura ya quedó atrás. Para conseguir precisión real hay que superponer varias técnicas.
- Búsqueda híbrida (BM25 + vectores): combinar coincidencia léxica y similitud semántica. BM25 cubre lo que es débil para los vectores: nombres propios, números de modelo, números de cláusula
- Introducir un reranker: tomar el conjunto amplio de la primera búsqueda y reordenarlo con Cohere Rerank o un modelo tipo ColBERT. La calidad del top 5 mejora de forma drástica
- Descomposición de consultas: dividir preguntas compuestas como “explícame la diferencia entre A y B” en varias subconsultas mediante un LLM y buscarlas en paralelo
- Embeddings multilingües: para documentos en japonés adoptamos bge-m3. Estable incluso cuando se mezcla inglés
Un RAG que se salta esta capa puede verse decente en una demo, pero al ponerlo en operación choca de inmediato con un techo de precisión. Al revés: solo con cuidar bien esta capa, la calidad percibida cambia como si fuera otro producto.
Orquestación — hacia una búsqueda con estado
La tendencia reciente es la búsqueda con estado. Salimos del esquema “una sola búsqueda → respuesta” y evolucionamos hacia diseños que dan estado al propio proceso de búsqueda.
- Control de flujo con LangGraph y similares: describir explícitamente como un grafo el bucle de buscar → evaluar → volver a buscar si hace falta
- Self-Reflection: que el propio LLM juzgue si los fragmentos recuperados bastan para responder y, si no, vuelva a buscar con otra consulta
- Conservación del estado conversacional: heredar los documentos y filtros del turno anterior para que las preguntas de seguimiento no busquen desde cero
- Integración con llamadas a herramientas: invocar dinámicamente APIs internas o herramientas de cálculo según los resultados de la búsqueda
Llegados a este punto, ya no es tanto “búsqueda” como un agente que lleva la búsqueda dentro. Si el RAG tradicional es un diccionario estático, esto se parece más a un asistente que sale a recoger información con un objetivo.
Cómo pensamos la elección del modelo (LLM)
El LLM en sí depende del caso, pero solemos proponer un esquema de dos niveles: modelos de la familia GPT como eje cuando prima la precisión y modelos ligeros para áreas sensibles al coste.
- Estimar caso por caso el equilibrio entre calidad de generación y coste de inferencia
- Pasar las mismas preguntas por varios modelos y comparar puntuaciones contra un set de evaluación (decidir con números, no con impresiones)
- Cuando intervienen datos personales o información confidencial, elegir desde la ruta de la API y la política de retención hacia atrás
La clave no es “use el modelo más nuevo y ya está”, sino decidir con datos de evaluación.
¿Realmente conviene hacer RAG?
Lo cierto es que en una proporción nada despreciable de consultas acabamos diciendo: “esto no es un proyecto de RAG”. Los criterios son claros.
- Datos del orden de unos pocos miles de caracteres → ❌ es más rápido y preciso ponerlos directamente en el prompt
- Datos que se actualizan con frecuencia → ✅ encaja con RAG (sigue al ritmo sin reentrenar)
- Precisión de búsqueda crítica para el negocio → ✅ encaja con RAG (con la configuración 2.0 anterior)
- Se requiere control de flujo complejo → ❌ un RAG por sí solo no basta. Hace falta diseño de agentes
Si arrancas sin tenerlo claro aquí, acabas montando RAG sobre un problema que no debería resolverse con RAG, y la fase de operación termina quemando solo coste. Vale la pena dedicar la primera semana a ordenar requisitos.
Evaluación y operación — para que no se quede en PoC
Con RAG, lo bueno no es construirlo, sino lo que viene después. Junto con la construcción inicial montamos también el andamiaje de evaluación y operación.
- Preparar pronto un set de evaluación pregunta → respuesta esperada → fuente esperada
- Puntuar de forma continua Recall / Precision / corrección de la respuesta
- Llevar a CI el procedimiento de reindexación al añadir o revisar documentos
- Acumular feedback de usuarios (👍 / 👎) y devolverlo al ajuste del reranker y de los parámetros de búsqueda
Sin un set de evaluación, discutir “no sale la precisión” es dar vueltas en círculos. Construir desde el principio un estado en el que se puede hablar con números acaba siendo el camino más corto.
También para su proyecto
RAG es un terreno donde alinear librerías por sí solo no produce precisión. Búsqueda híbrida, reranker, descomposición de consultas, gestión de estado — qué combinar y qué dejar fuera es lo que separa un buen resultado del resto.
Nos ocupamos de extremo a extremo de la construcción, evaluación y operación de un RAG de nueva generación centrado en LlamaIndex / Qdrant / bge-m3. Búsqueda en conocimiento interno, atención al cliente semiautomatizada, plataformas de Q&A sobre normativas y contratos: hablemos desde la fase “¿de verdad funciona con nuestros datos?”.