CASE STUDY
次世代 RAG 検索システム開発
ハイブリッド検索・Reranker・状態を持つオーケストレーションを組み合わせた『RAG 2.0』設計。LlamaIndex + Qdrant + bge-m3 を軸に、単発検索では届かない精度と運用性を狙うアプローチ。
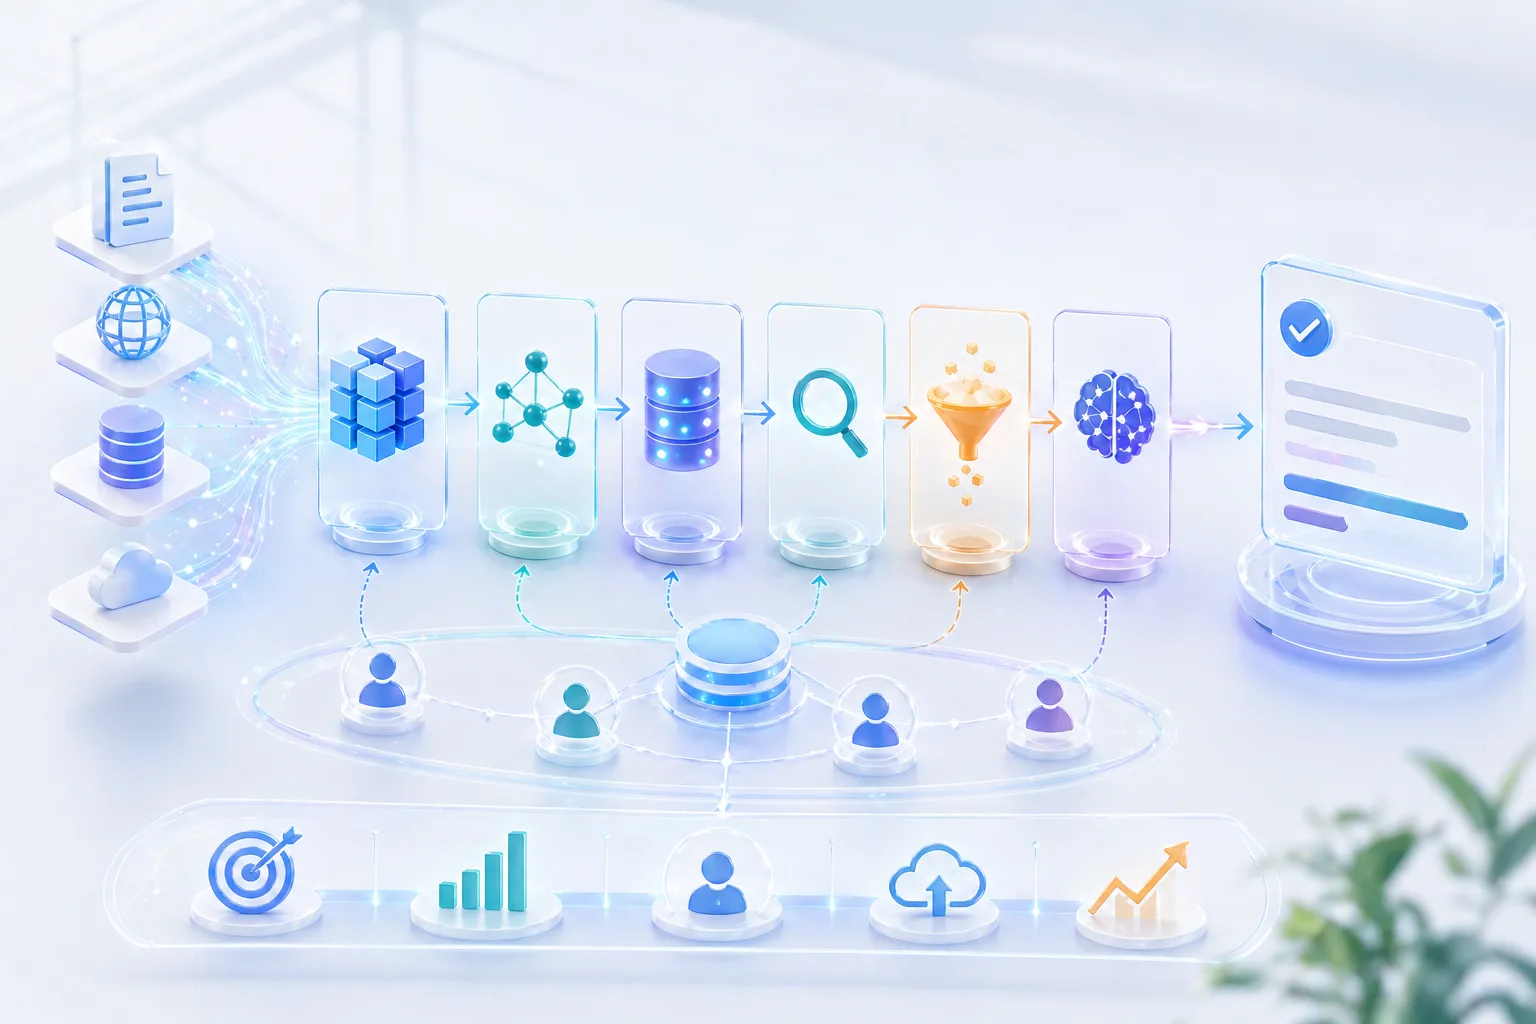
なぜ今『RAG 2.0』なのか
生成 AI を業務に組み込む案件で、いま最も多い相談が「社内文書を検索させたい」です。ところが、ベクトル DB に放り込んで類似度検索するだけの 素朴な RAG では実用精度に届かない ことが、ここ 1 年で広く知られるようになりました。
理由はシンプルで、意味的な近さと、業務上の正解とは別物 だからです。「請求書の支払期日に関する社内規定」を聞いたとき、ベクトル類似度の上位に来るのは「支払」「期日」を含む雑多な議事録だったりします。本当に欲しいのは、規定集の特定条文 1 件です。
ここを埋めるのが、いわゆる RAG 2.0 ── ハイブリッド検索、再ランキング、クエリ分解、そして状態を持つオーケストレーション。私たちはこれらを組み合わせ、実運用で耐える検索体験 に仕立てます。
開発アプローチの全体像
私たちの構築する RAG は、単発の「検索 → 回答」ではありません。クエリを分解し、ハイブリッドで一次集合を集め、Reranker で並び替え、必要に応じて再検索する ── 状態を持った検索フロー として設計します。基盤は LlamaIndex + Qdrant、埋め込みは OpenAI Embeddings と bge-m3 を用途で使い分け、生成は GPT 系を中心に据えます。4 週間規模 で PoC から検証可能な状態まで持っていくのが標準的なスコープです。
Retrieval 戦略 ── ここが『RAG 2.0』の肝
単純なベクトル検索はもう古い、というのが私たちの立場です。検索精度を出すには 複数の手法を重ねる 必要があります。
- ハイブリッド検索 (BM25 + ベクトル): キーワード一致と意味的類似度を併用。固有名詞・型番・条文番号など、ベクトルが弱い領域を BM25 が補完
- Reranker の導入: 一次検索で広めに集めた候補を、Cohere Rerank や ColBERT 系で並び替え。上位 5 件の質が劇的に上がる
- クエリ分解: 「A と B の違いを教えて」のような複合質問を、LLM で複数のサブクエリに割って並列検索
- 多言語埋め込み: 日本語ドキュメントには bge-m3 を採用。英語混在でも安定
ここを省いた RAG は、デモではそれなりに見えても、現場で使うとすぐに精度の頭打ち が来ます。逆に言えば、ここを丁寧にやるだけで体感品質はまるで別物になります。
オーケストレーション ── 状態を持つ検索へ
最近のトレンドは状態を持つ検索です。「単発検索 → 回答」から脱却し、検索プロセス自体に状態を持たせる 設計に進化しています。
- LangGraph 等によるフロー制御: 検索 → 評価 → 必要なら再検索、というループを明示的にグラフで記述
- Self-Reflection: 取得チャンクが質問に答えるのに十分かを LLM 自身に判定させ、不足なら再度別クエリで取得
- 会話状態の保持: 直前のターンで参照した文書・絞り込み条件を引き継ぎ、フォローアップ質問でゼロから探さない
- ツール呼び出しとの統合: 検索結果に応じて、社内 API や計算ツールを動的に呼び出す
ここまで来ると「検索」というより、もはや 検索を内包したエージェント です。従来 RAG が静的な辞書だとすれば、こちらは 目的を持って情報を集めに行くアシスタント に近いですね。
モデル (LLM) 選定の考え方
LLM そのものは用途次第ですが、私たちは 精度重視なら GPT 系を中軸、コスト感度が高い領域には軽量モデル、という二段構えで提案することが多いです。
- 生成品質と推論コストのトレードオフを案件ごとに見積もる
- 同じ質問を複数モデルで走らせて評価セットでスコア比較 (主観評価ではなく数値で決める)
- 個人情報・機密が絡む場合は、API 経路と保管ポリシーから逆算して選定
「とりあえず最新モデル」ではなく、評価データで決める のがポイントです。
そもそも RAG をやるべきか
実は、相談を受けて「これは RAG 案件ではないですよ」とお伝えするケースも一定割合あります。判断軸は明快です。
- データが 数千文字レベル → ❌ プロンプトに直接入れた方が速くて正確
- データが 頻繁に更新される → ✅ RAG 向き (再学習不要で追従できる)
- 検索精度 が業務クリティカル → ✅ RAG 向き (上記の 2.0 構成で)
- 複雑なフロー制御 が必要 → ❌ 単体 RAG では不足。エージェント設計が必要
ここを曖昧にしたまま着手すると、RAG で解くべきでない問題に RAG を載せてしまい、運用フェーズでコストばかりかかる ── という不幸が起きます。最初の 1 週間は要件整理に使う価値があります。
評価と運用 ── PoC で終わらせないために
RAG は 作って終わり、ではなく作ってからが本番 です。私たちは初期構築と同時に、評価・運用の足場を組みます。
- 質問 → 期待回答 → 期待ソース の評価セットを早期に整備
- Recall / Precision / 回答正確性を 継続的にスコアリング
- 文書追加・改訂時の再インデックス手順を CI 化
- ユーザーフィードバック (👍 / 👎) を蓄積し、Reranker や検索パラメータの調整に還元
評価セットがないまま「精度が出ない」と議論しても堂々巡りです。数字で語れる状態を最初に作る のが、結果的に一番の近道になります。
御社のプロジェクトにも
RAG は、ライブラリを並べるだけでは精度が出ない 領域です。ハイブリッド検索・Reranker・クエリ分解・状態管理 ── どこを組み合わせ、どこは省くかの判断が成果を分けます。
弊社は、LlamaIndex / Qdrant / bge-m3 を中心とした 次世代 RAG の構築・評価・運用 を一気通貫でお引き受けします。社内ナレッジ検索、顧客対応の半自動化、規程・契約書の Q&A 基盤など、「うちのデータで効くのか?」 という段階からご相談ください。