BLOG
바이브 코딩 시대에 중소기업이 SaaS를 만들 때 DB의 최적해 — Cloudflare D1 × 싱글 테넌트가 DB 비용의 벽을 부순다
AI(바이브 코딩)로 『만드는』 비용은 사라졌습니다. 대량의 서비스를 운영해 나갈 때의 DB 비용을 생각합니다.
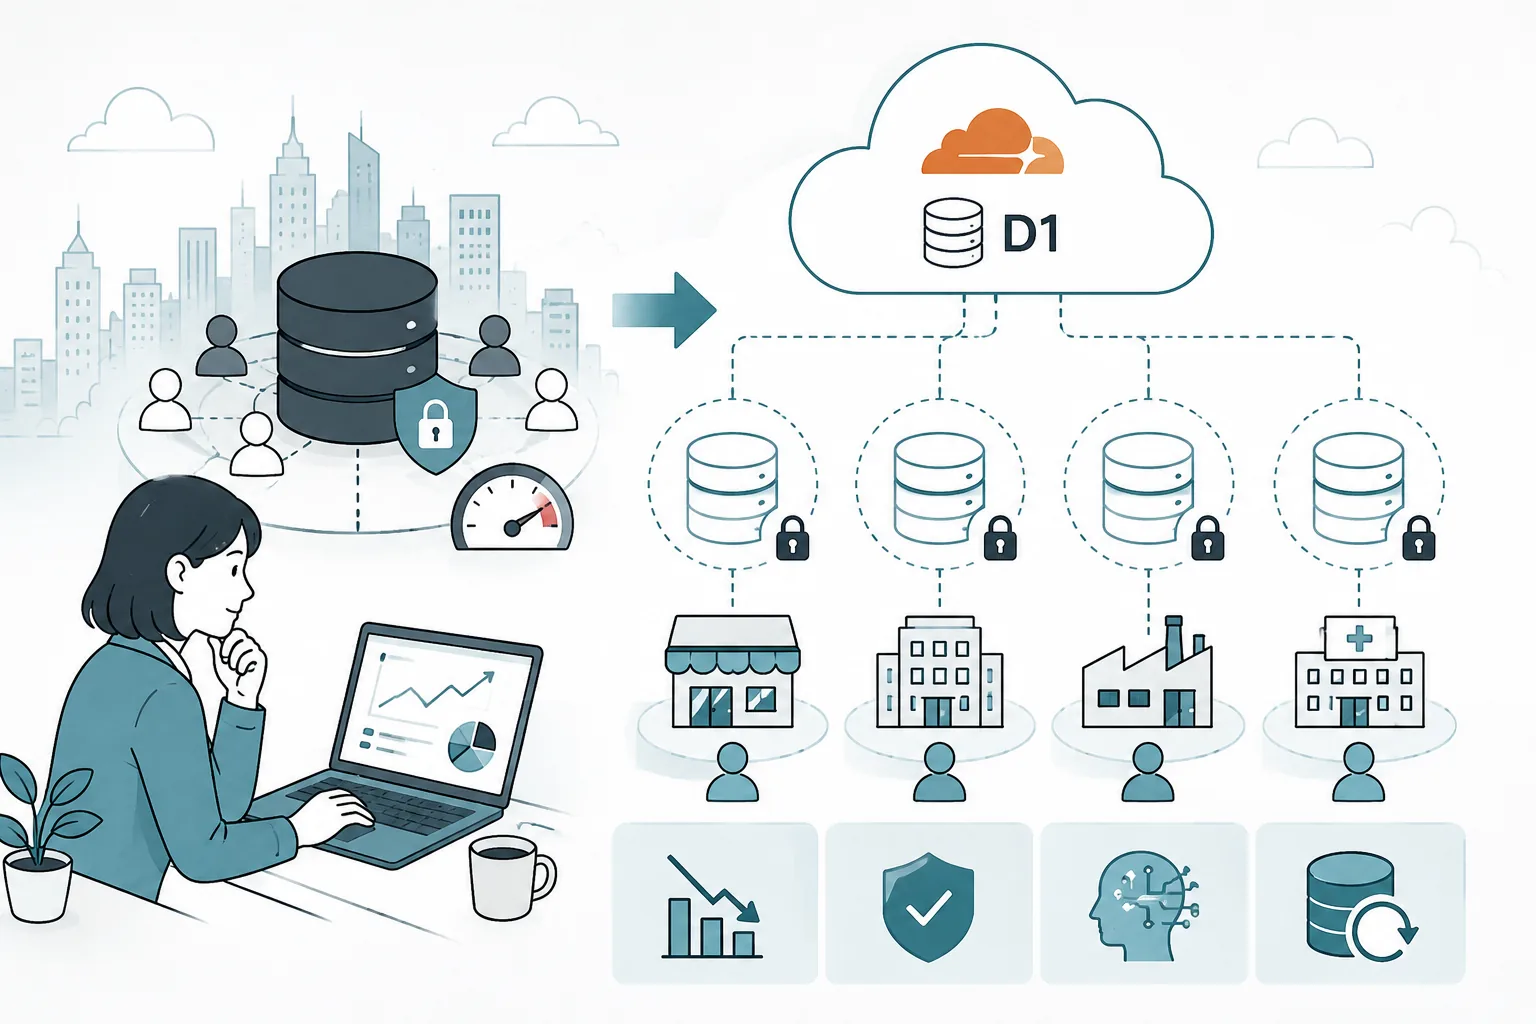
AI에 의해 「기능을 만든다」는 비용은 거의 제로에 가까워졌습니다. 소수 인원의 팀이라도 대기업과 같은 기능을, 같은 속도로 내놓을 수 있게 되었습니다. 그럼에도 서비스를 공개한 순간 가로막는 것이 「인프라의 고정비」 — 특히 AWS RDS로 대표되는 점유형 데이터베이스의 유지 비용입니다.
이 벽을 Cloudflare D1과 「고객 1명당 DB 1개」의 싱글 테넌트 전략으로 정면에서 부순다. 그것이 지금, 중소기업이 대규모 SaaS를 운영하기 위한 최단 루트라고 생각합니다.
「1개의 DB에 전원을 넣는」 시대는 끝났다
지금까지 대규모 SaaS가 멀티 테넌트(하나의 거대한 RDB에 모든 고객을 합승시키는 방식)를 선택해 온 이유는 거의 한 가지뿐입니다. RDS나 Aurora의 고정비가 너무 비싸서, 합승하지 않으면 채산이 맞지 않았던 것입니다.
다만 합승에는 항상 대가가 따라붙습니다.
- 보안 사고의 온상:
WHERE tenant_id = ?의 깜빡 누락 한 방으로 다른 회사의 데이터가 섞여 들어갑니다. 리뷰에서 아무리 신경 써도 0으로 만들 수는 없습니다. - 시끄러운 이웃 문제: 특정 거대 고객의 쿼리가 막히면 관계없는 다른 회사까지 함께 느려집니다.
- AI 활용의 어려움: RAG로 「이 고객의 데이터만」을 넘기고 싶을 때, 모든 고객이 섞인 DB에서 안전하게 뽑아내는 로직은 상상 이상으로 무겁습니다. 프롬프트 인젝션으로 다른 회사 데이터에 도달하는 사고도 실제로 일어나고 있습니다.
이런 구조는 AI로 무엇이든 만들 수 있는 시대에 그대로 끌고 가도 될 것은 아니라고 생각합니다.
Cloudflare D1이 인프라의 전제를 바꾼다
D1은 SQLite를 기반으로 Cloudflare의 엣지에 분산 배치된 서버리스 관계형 DB입니다. SaaS를 양산하는 쪽에서는 무엇이 다른가.
- 고정비가 거의 제로: 유휴 상태의 DB에 돈을 낼 필요가 없습니다. 100개의 DB를 「혹시 몰라서」 켜둔 채로 두어도 비어 있는 한 과금되지 않습니다.
- 동적으로 DB를 생성할 수 있다: 신규 계약 때마다 API 한 번으로 「그 고객 전용 D1을 1개 만든다」가 성립합니다. RDS에서 같은 일을 하려고 하면, 우선 경리에게 혼납니다.
- Workers와 지속된다: Worker로부터의 접근은 네트워크적으로 거의 제로 홉입니다. 멀티 리전 읽기도 기본으로 따라옵니다.
지금까지 「너무 사치스러워 할 수 없었던」 싱글 테넌트 구성이, D1에서는 기본 선택지로 바뀝니다.
싱글 테넌트(고객 1명당 DB 1개)의 압도적 우위성
중소기업이 대기업과 싸울 때, 이 구성은 그대로 영업 토크가 됩니다.
「물리적으로 격리되어 있습니다」라고 말할 수 있다
B2B SaaS의 상담에서 정보 시스템이나 법무가 가장 먼저 묻는 것은 「다른 회사와 데이터가 나뉘어 있는가」입니다. 멀티 테넌트라면 「논리적으로 분리되어 있습니다」라고밖에 말할 수 없지만, 싱글 테넌트라면 「DB 파일 자체가 다른 것입니다」라고 즉답할 수 있습니다. 이것은 계약 체결 속도에 직결됩니다.
AI / RAG가 압도적으로 심플해진다
DB가 고객별로 나뉘어 있다면, AI에게 참조시킬 범위는 처음부터 물리적으로 확정되어 있습니다.
- 「이 고객의 DB만 읽어라」라고 말하면 끝.
- 다른 회사 데이터로의 월경 쿼리는 구조적으로 불가능.
- 검색 정밀도도 노이즈가 줄어드는 만큼 올라갑니다.
멀티 테넌트로 RAG의 권한 분리를 열심히 하는 것보다, 먼저 DB를 나눠 버리는 쪽이 결과적으로 빠릅니다.
데이터의 포터빌리티
「해약하니까 데이터를 돌려달라」고 했을 때, SQLite 파일 한 개를 건네면 끝납니다. 익스포트 배치를 매번 짤 필요가 없습니다. 해약 시의 경험이 좋은 SaaS는 재계약률도 높다는 것이 개인적인 관찰입니다.
단점과, 그것을 넘어서는 「각오」
물론 은총알은 아닙니다. 싱글 테넌트 양산에는 고유의 어려움이 있습니다.
마이그레이션의 자동화는 필수
1,000개의 DB에 일제히 컬럼을 추가한다는 오퍼레이션이 일상이 됩니다. 수작업은 처음부터 불가능 — 마이그레이션 러너를 자체적으로 가지고, 실패 시의 롤백과 재시도까지 세트로 짤 필요가 있습니다. 여기는 AI에게 쓰게 하더라도, 인간이 최종 리뷰하는 영역입니다.
횡단 분석에는 별도 파이프라인이 필요하다
「전체 고객의 월간 액티브를 내라」고 했을 때, 1,000개의 D1에 개별로 SQL을 던지고 돌리는 것은 현실적이지 않습니다.
- 각 D1 → 분석용 DB(DuckDB, BigQuery, ClickHouse 등)로 ETL을 돌린다.
- 집계는 그쪽에서 한다.
요컨대 OLTP와 OLAP를 처음부터 분리하는 설계입니다. 멀티 테넌트에서는 「같은 DB에서 양쪽 다 하는」 유혹에 지기 쉽지만, 싱글 테넌트는 강제적으로 올바른 구조로 몰아넣어집니다.
거대화된 고객의 「졸업 플랜」
싱글 테넌트 시대에도 1개의 DB가 용량・QPS의 상한에 부딪치는 일은 있습니다. 그 고객만을 다른 인프라(전용 D1, 또는 다른 구성의 RDS 등)로 도려낼 수 있는 설계를 처음부터 심어둡니다. 테넌트 ID로부터 접속처 DB를 해결하는 레이어를 반드시 한 장 끼워 넣는다는 것이 구체적인 대응입니다.
인프라를 제압하는 자가, AI 시대의 SaaS를 제압한다
AI로 「만드는」 비용이 사라지는 세계에서는, 승패를 가르는 것은 **「얼마나 낮은 비용으로, 안전하게, 스케일러블하게 계속 운영할 수 있는가」**입니다.
중후장대한 RDS의 고정비에 묶인 채로 AI 기능을 쌓아도 수익 구조는 건전해지지 않습니다. Cloudflare D1으로 DB를 양산하고, 고객별로 최적화된 가치를 싱글 테넌트의 안심감과 함께 전달한다. 이 조합은 중소기업이 대규모 SaaS를 자칭하기 위한 가장 현실적인 장비라고 생각합니다.
주식회사 와이어드앤에코에서는 이 구성을 전제로 한 SaaS 개발・마이그레이션 상담을 받고 있습니다. 기존 멀티 테넌트 SaaS의 싱글 테넌트화 검토, D1으로의 마이그레이션 설계, 양산기의 마이그레이션 운영 설계 등 부담 없이 문의 주십시오.