CASE STUDY
차세대 RAG 검색 시스템 개발
하이브리드 검색·Reranker·상태를 가진 오케스트레이션을 결합한 『RAG 2.0』 설계. LlamaIndex + Qdrant + bge-m3 를 축으로, 단발 검색으로는 닿지 못하는 정확도와 운영성을 노리는 접근.
왜 지금 『RAG 2.0』 인가
생성 AI 를 업무에 도입하는 안건에서, 지금 가장 많이 받는 상담이 “사내 문서를 검색하게 하고 싶다” 입니다. 그런데 벡터 DB 에 그냥 던져 넣고 유사도 검색만 돌리는 소박한 RAG 로는 실용 정확도에 닿지 않는다 는 사실이 지난 1년 사이 널리 알려졌습니다.
이유는 단순합니다. 의미적 유사함과 업무상의 정답은 다른 것 이기 때문입니다. “청구서 지급 기일에 관한 사내 규정” 을 물었을 때, 벡터 유사도 상위에 올라오는 것은 “지급” “기일” 이 들어간 잡다한 회의록이기 일쑤입니다. 정작 원하는 건 규정집의 특정 조문 하나인데 말이죠.
이 간극을 메우는 것이 이른바 RAG 2.0 ── 하이브리드 검색, 재랭킹, 쿼리 분해, 그리고 상태를 가진 오케스트레이션입니다. 우리는 이것들을 조합해 실운영에서 견디는 검색 경험 으로 다듬어 냅니다.
개발 접근의 전체 그림
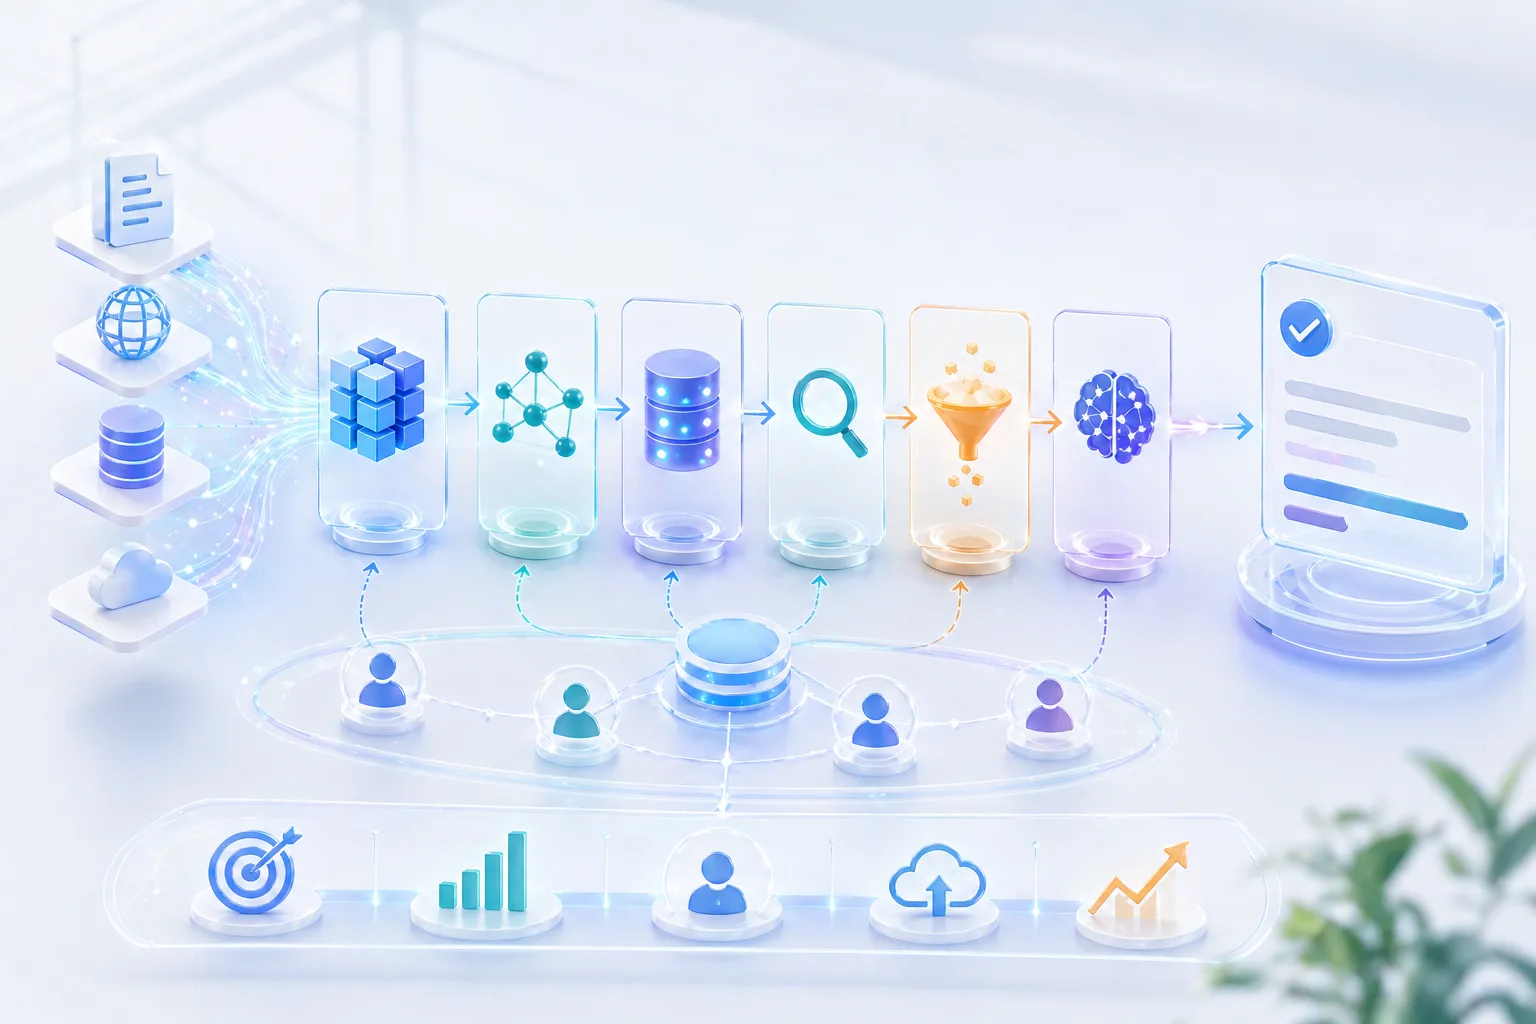
우리가 만드는 RAG 는 단발의 “검색 → 답변” 이 아닙니다. 쿼리를 분해하고, 하이브리드로 1차 집합을 모으고, Reranker 로 재정렬하고, 필요하면 다시 검색하는 ── 상태를 가진 검색 플로우 로 설계합니다. 기반은 LlamaIndex + Qdrant, 임베딩은 OpenAI Embeddings 와 bge-m3 를 용도별로 구분해 사용하고, 생성은 GPT 계열을 중심에 둡니다. 약 4주 규모 로 PoC 부터 검증 가능한 상태까지 끌고 가는 것이 표준 스코프입니다.
Retrieval 전략 ── 여기가 『RAG 2.0』 의 핵심
단순 벡터 검색은 이미 낡았다는 것이 우리의 입장입니다. 검색 정확도를 내려면 여러 기법을 겹쳐 쌓아야 합니다.
- 하이브리드 검색 (BM25 + 벡터): 키워드 일치와 의미적 유사도를 병용. 고유 명사·모델 번호·조문 번호처럼 벡터가 약한 영역을 BM25 가 보완
- Reranker 도입: 1차 검색에서 넓게 모아 둔 후보를 Cohere Rerank 나 ColBERT 계열로 재정렬. 상위 5건의 품질이 극적으로 올라갑니다
- 쿼리 분해: “A 와 B 의 차이를 알려 줘” 같은 복합 질문을 LLM 으로 여러 서브쿼리로 쪼개 병렬 검색
- 다국어 임베딩: 일본어 문서에는 bge-m3 를 채택. 영어가 섞여도 안정적
이 부분을 빼먹은 RAG 는 데모에서는 그럴듯해 보여도, 현장에 투입하면 곧바로 정확도 천장 에 부딪힙니다. 반대로 이 부분만 꼼꼼히 해도 체감 품질은 완전히 다른 제품이 됩니다.
오케스트레이션 ── 상태를 가진 검색으로
요즘 트렌드는 상태를 가진 검색입니다. “단발 검색 → 답변” 에서 벗어나 검색 프로세스 자체에 상태를 갖게 하는 설계로 진화하고 있습니다.
- LangGraph 등에 의한 플로우 제어: 검색 → 평가 → 필요하면 재검색의 루프를 그래프로 명시적으로 기술
- Self-Reflection: 가져온 청크가 질문에 답하기에 충분한지 LLM 자신에게 판정시키고, 부족하면 다른 쿼리로 재취득
- 대화 상태 유지: 직전 턴에서 참조한 문서·필터 조건을 이어받아, 후속 질문에서 처음부터 찾지 않음
- 툴 호출과의 통합: 검색 결과에 따라 사내 API 나 계산 도구를 동적으로 호출
여기까지 오면 “검색” 이라기보다 이미 검색을 내포한 에이전트 입니다. 기존 RAG 가 정적인 사전이라면, 이쪽은 목적을 가지고 정보를 모으러 가는 어시스턴트 에 가깝습니다.
모델 (LLM) 선정의 사고방식
LLM 자체는 용도에 따르지만, 우리는 정확도 우선이라면 GPT 계열을 중축, 비용 민감도가 높은 영역에는 경량 모델, 이라는 이중 구조로 제안하는 경우가 많습니다.
- 생성 품질과 추론 비용의 트레이드오프를 안건마다 견적
- 같은 질문을 복수 모델로 돌려 평가셋에서 점수를 비교 (주관 평가가 아니라 수치로 결정)
- 개인정보·기밀이 얽히는 경우, API 경로와 보관 정책으로부터 역산해 선정
“일단 최신 모델” 이 아니라 평가 데이터로 결정 하는 것이 핵심입니다.
애초에 RAG 를 해야 할까
사실 상담을 받고 “이건 RAG 안건이 아닙니다” 라고 말씀드리는 케이스도 일정 비율 있습니다. 판단 기준은 명료합니다.
- 데이터가 수천 자 수준 → ❌ 프롬프트에 직접 넣는 편이 빠르고 정확
- 데이터가 자주 갱신됨 → ✅ RAG 적합 (재학습 없이 따라갈 수 있음)
- 검색 정확도 가 업무에 크리티컬 → ✅ RAG 적합 (위의 2.0 구성으로)
- 복잡한 플로우 제어 가 필요 → ❌ 단일 RAG 로는 부족. 에이전트 설계 필요
여기를 모호하게 둔 채 착수하면 RAG 로 풀어선 안 될 문제에 RAG 를 얹어 버려서, 운영 단계에서 비용만 드는 ── 그런 불행이 일어납니다. 처음 1주는 요건 정리에 쓸 가치가 있습니다.
평가와 운영 ── PoC 로 끝내지 않기 위해
RAG 는 만들고 끝이 아니라, 만들고 나서가 본 게임 입니다. 우리는 초기 구축과 동시에 평가·운영의 발판을 함께 짭니다.
- 질문 → 기대 답변 → 기대 소스 의 평가셋을 조기에 정비
- Recall / Precision / 답변 정확성을 지속적으로 스코어링
- 문서 추가·개정 시의 재인덱싱 절차를 CI 화
- 사용자 피드백 (👍 / 👎) 을 축적해 Reranker 와 검색 파라미터 조정에 환원
평가셋 없이 “정확도가 안 나온다” 를 논의해 봐야 제자리걸음입니다. 숫자로 말할 수 있는 상태를 가장 먼저 만드는 것이 결과적으로 가장 빠른 길입니다.
귀사의 프로젝트에도
RAG 는 라이브러리를 늘어놓기만 해선 정확도가 나오지 않는 영역입니다. 하이브리드 검색·Reranker·쿼리 분해·상태 관리 ── 어디를 조합하고 어디를 빼는가의 판단이 성과를 가릅니다.
저희는 LlamaIndex / Qdrant / bge-m3 를 중심으로 한 차세대 RAG 의 구축·평가·운영 을 일관되게 맡습니다. 사내 지식 검색, 고객 응대의 반자동화, 규정·계약서 Q&A 기반 등, “우리 데이터에서 잘 작동할까?” 라는 단계부터 상담해 주십시오.