CASE STUDY
下一代 RAG 檢索系統開發
結合混合檢索、Reranker 與有狀態編排的『RAG 2.0』設計。以 LlamaIndex + Qdrant + bge-m3 為核心,瞄準單次檢索無法企及的精度與可運營性的方法論。
為什麼是現在的『RAG 2.0』
在將生成式 AI 引入業務的項目裡,目前最多的諮詢就是「想讓公司內部文檔能被檢索」。然而過去一年裡大家已經普遍意識到,只是把文檔丟進向量數據庫做相似度檢索的樸素 RAG,根本達不到可用精度。
原因很簡單 ── 語義上的相近,與業務上的正確答案,是兩件不同的事。當問到「關於發票付款期限的公司內部規定」時,向量相似度排在前面的往往是包含「付款」「期限」字眼的雜項會議紀要;真正想要的,其實是規章中那一條具體條文。
填補這一落差的,就是所謂的 RAG 2.0 ── 混合檢索、再排序、查詢分解,以及有狀態的編排。我們把這些組合起來,打造能夠在生產環境長期支撐的檢索體驗。
開發方法的整體圖景
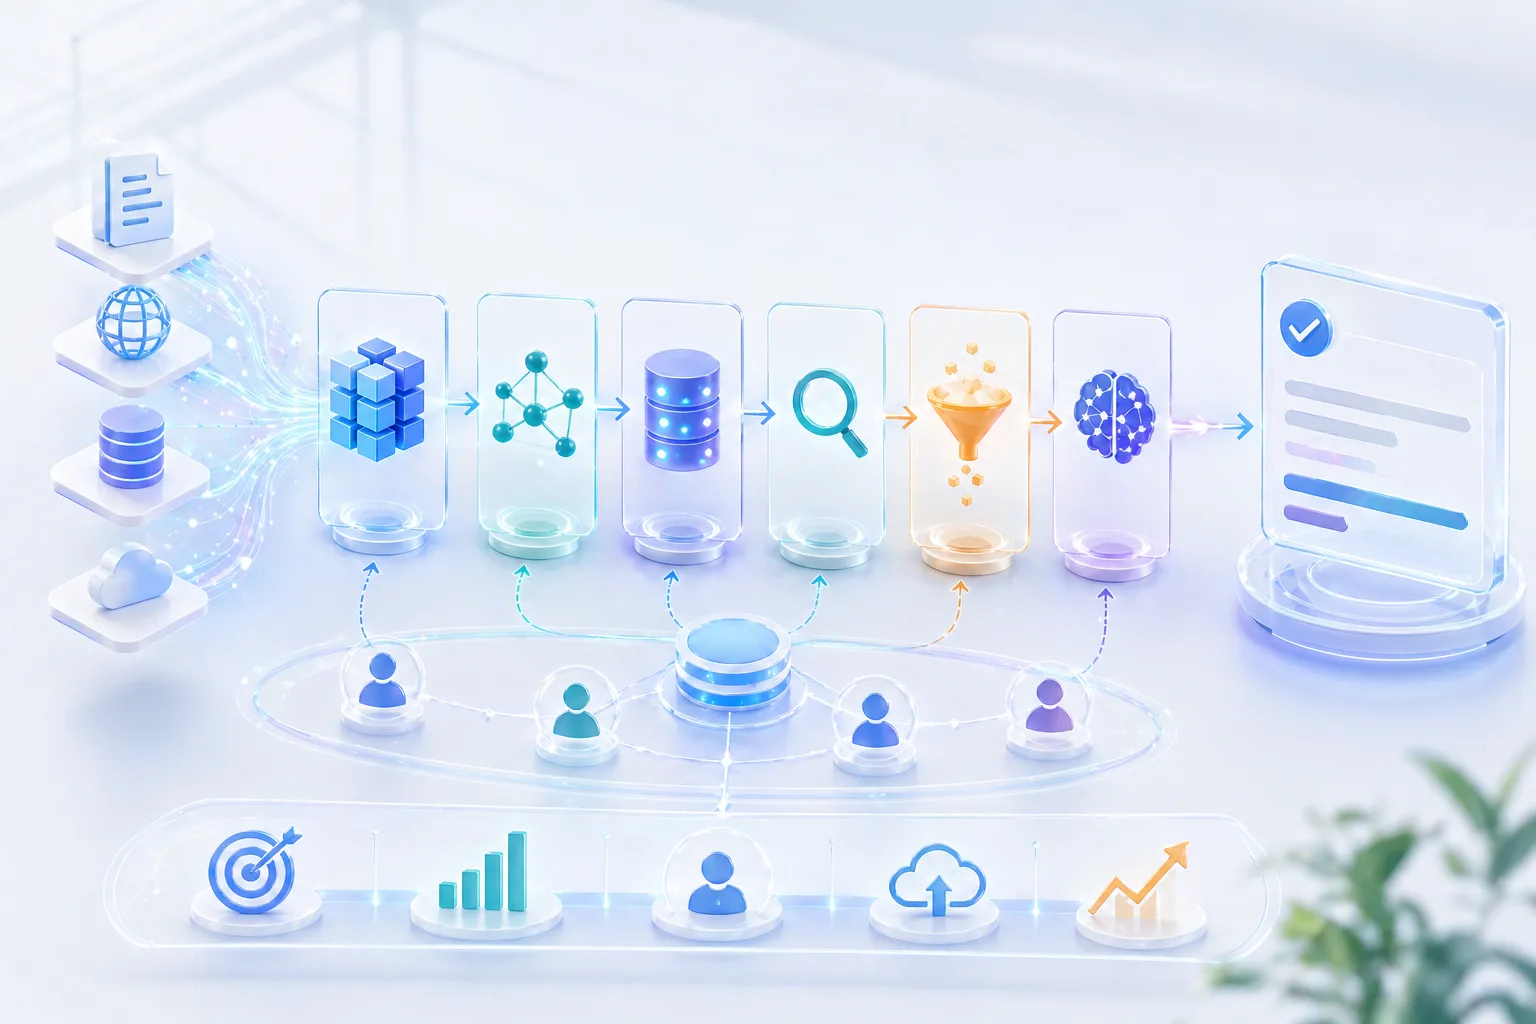
我們構建的 RAG 不是一次性的「檢索 → 回答」。它會拆分查詢,用混合檢索收集一次集合,經由 Reranker 重新排序,必要時再次檢索 ── 設計成 有狀態的檢索流程。基礎是 LlamaIndex + Qdrant,Embedding 根據用途在 OpenAI Embeddings 與 bge-m3 之間區分使用,生成端以 GPT 系列為核心。約 4 周量級 把項目從 PoC 推進到可驗證狀態,是我們的標準範圍。
檢索策略 ── 這就是『RAG 2.0』的核心
我們的立場是:單純的向量檢索已經過時。要真正做出檢索精度,必須把多種手法疊加使用。
- 混合檢索 (BM25 + 向量): 關鍵詞匹配與語義相似度並用。專有名詞、型號編號、條文編號等向量本身較弱的領域,由 BM25 來補強
- 引入 Reranker: 把一次檢索時較廣收集的候選,用 Cohere Rerank 或 ColBERT 類模型重新排序。前 5 名的質量會戲劇性地提升
- 查詢分解: 把「告訴我 A 與 B 的差異」這類複合問題用 LLM 拆分成多個子查詢並行檢索
- 多語言 Embedding: 日文文檔採用 bge-m3。即便夾雜英文也很穩定
省掉這一層的 RAG,在 Demo 裡看著還行,一進入實際現場馬上就撞上精度天花板。反過來說,光是把這一層做紮實,體感品質就會像換了產品一樣不同。
編排 ── 走向有狀態的檢索
近來的趨勢是有狀態的檢索。從「單次檢索 → 回答」中跳脫出來,演進為 讓檢索過程本身持有狀態 的設計。
- 基於 LangGraph 等的流程控制: 把檢索 → 評估 → 必要時再檢索的循環,顯式以圖描述
- Self-Reflection: 讓 LLM 自己判斷已取得的 chunk 是否足以回答問題,不足時改用別的查詢重新取得
- 會話狀態保持: 沿用上一輪所引用的文檔與篩選條件,後續問題不必從零再找
- 與工具調用的整合: 根據檢索結果,動態調用公司內部 API 或計算工具
走到這一步,與其說是「檢索」,不如說已經是 內含檢索的 Agent 了。如果傳統 RAG 是一本靜態字典,這邊就更接近 帶著目的去搜集信息的助手。
模型 (LLM) 選型的思路
LLM 本身視用途而定,我們經常以 精度優先則以 GPT 系列為主軸、對成本敏感的領域則用輕量模型 這樣的雙層結構來提案。
- 按項目逐一評估生成質量與推理成本之間的權衡
- 把同一個問題在多個模型上跑過,基於評估集做分數比較 (用數字而不是主觀感受決定)
- 涉及個人信息或機密時,從 API 路徑與保留策略反推選型
要點不是「先用最新模型再說」,而是 用評估數據來決定。
這個項目到底該不該上 RAG
其實在諮詢裡,我們也有一定比例會回覆「這不是 RAG 項目」。判斷軸很清楚。
- 數據規模在 幾千字級別 → ❌ 直接放進 Prompt 更快也更準
- 數據 更新頻繁 → ✅ 適合 RAG (無需再訓練即可跟上)
- 檢索精度 對業務至關重要 → ✅ 適合 RAG (用上述 2.0 方案)
- 需要 複雜的流程控制 → ❌ 單一 RAG 不夠。需要 Agent 設計
如果不把這裡弄清楚就貿然開工,會把不該用 RAG 解的問題硬塞給 RAG,到了運營階段就只剩成本在燒 ── 這種悲劇時有發生。最初一週值得花在需求梳理上。
評估與運營 ── 不讓項目止步於 PoC
RAG 不是做完就結束,做完之後才是正賽。我們在初期構建的同時,就把評估與運營的腳手架一併搭好。
- 問題 → 預期答案 → 預期來源 的評估集儘早整備
- Recall / Precision / 回答準確性的 持續性打分
- 文檔新增、修訂時的再索引流程納入 CI
- 累積用戶反饋 (👍 / 👎),迴流到 Reranker 與檢索參數的調整中
沒有評估集就討論「精度上不去」,只會原地打轉。先把能用數字說話的狀態建立起來,反而是最快的路。
也歡迎託付貴司的項目
RAG 是一個 光把庫擺在一起精度也出不來 的領域。混合檢索、Reranker、查詢分解、狀態管理 ── 哪些組合、哪些捨去,正是決定成果的判斷。
我司以 LlamaIndex / Qdrant / bge-m3 為核心,一站式承接下一代 RAG 的構建、評估與運營。公司內部知識檢索、客戶應對的半自動化、規章與合同的 Q&A 平臺等,「在我們的數據上真的有效嗎?」 這一階段就請來諮詢。