CASE STUDY
下一代 RAG 检索系统开发
结合混合检索、Reranker 与有状态编排的『RAG 2.0』设计。以 LlamaIndex + Qdrant + bge-m3 为核心,瞄准单次检索无法企及的精度与可运营性的方法论。
为什么是现在的『RAG 2.0』
在将生成式 AI 引入业务的项目里,目前最多的咨询就是「想让公司内部文档能被检索」。然而过去一年里大家已经普遍意识到,只是把文档丢进向量数据库做相似度检索的朴素 RAG,根本达不到可用精度。
原因很简单 ── 语义上的相近,与业务上的正确答案,是两件不同的事。当问到「关于发票付款期限的公司内部规定」时,向量相似度排在前面的往往是包含「付款」「期限」字眼的杂项会议纪要;真正想要的,其实是规章中那一条具体条文。
填补这一落差的,就是所谓的 RAG 2.0 ── 混合检索、再排序、查询分解,以及有状态的编排。我们把这些组合起来,打造能够在生产环境长期支撑的检索体验。
开发方法的整体图景
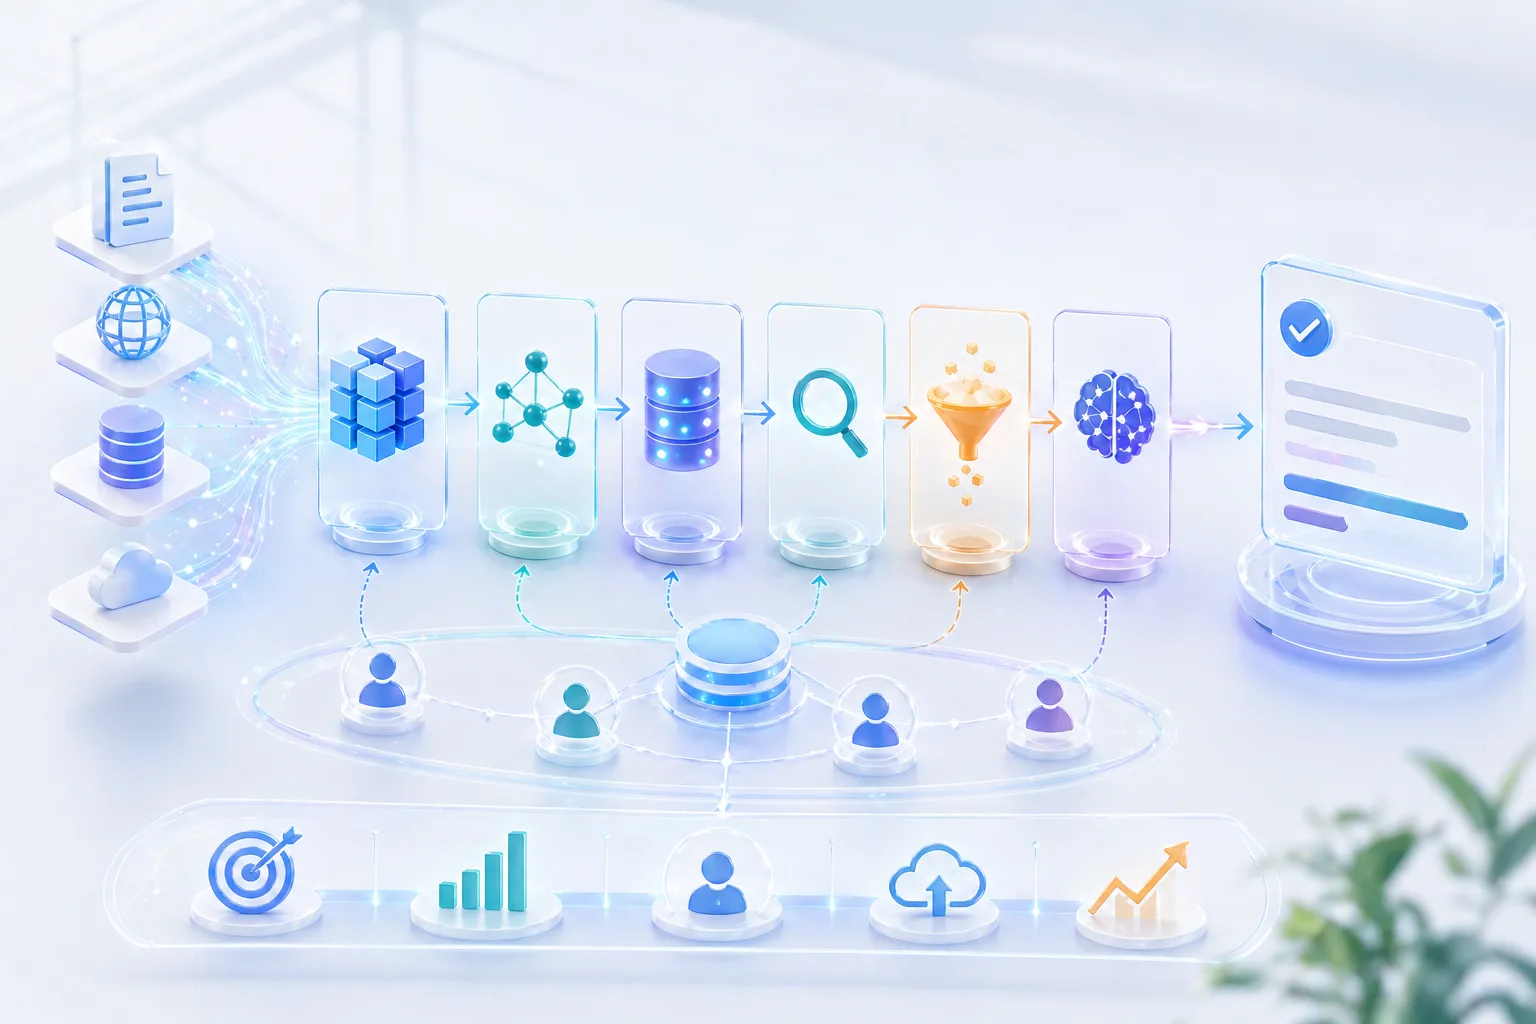
我们构建的 RAG 不是一次性的「检索 → 回答」。它会拆分查询,用混合检索收集一次集合,经由 Reranker 重新排序,必要时再次检索 ── 设计成 有状态的检索流程。基础是 LlamaIndex + Qdrant,Embedding 根据用途在 OpenAI Embeddings 与 bge-m3 之间区分使用,生成端以 GPT 系列为核心。约 4 周量级 把项目从 PoC 推进到可验证状态,是我们的标准范围。
检索策略 ── 这就是『RAG 2.0』的核心
我们的立场是:单纯的向量检索已经过时。要真正做出检索精度,必须把多种手法叠加使用。
- 混合检索 (BM25 + 向量): 关键词匹配与语义相似度并用。专有名词、型号编号、条文编号等向量本身较弱的领域,由 BM25 来补强
- 引入 Reranker: 把一次检索时较广收集的候选,用 Cohere Rerank 或 ColBERT 类模型重新排序。前 5 名的质量会戏剧性地提升
- 查询分解: 把「告诉我 A 与 B 的差异」这类复合问题用 LLM 拆分成多个子查询并行检索
- 多语言 Embedding: 日文文档采用 bge-m3。即便夹杂英文也很稳定
省掉这一层的 RAG,在 Demo 里看着还行,一进入实际现场马上就撞上精度天花板。反过来说,光是把这一层做扎实,体感品质就会像换了产品一样不同。
编排 ── 走向有状态的检索
近来的趋势是有状态的检索。从「单次检索 → 回答」中跳脱出来,演进为 让检索过程本身持有状态 的设计。
- 基于 LangGraph 等的流程控制: 把检索 → 评估 → 必要时再检索的循环,显式以图描述
- Self-Reflection: 让 LLM 自己判断已取得的 chunk 是否足以回答问题,不足时改用别的查询重新取得
- 会话状态保持: 沿用上一轮所引用的文档与筛选条件,后续问题不必从零再找
- 与工具调用的整合: 根据检索结果,动态调用公司内部 API 或计算工具
走到这一步,与其说是「检索」,不如说已经是 内含检索的 Agent 了。如果传统 RAG 是一本静态字典,这边就更接近 带着目的去搜集信息的助手。
模型 (LLM) 选型的思路
LLM 本身视用途而定,我们经常以 精度优先则以 GPT 系列为主轴、对成本敏感的领域则用轻量模型 这样的双层结构来提案。
- 按项目逐一评估生成质量与推理成本之间的权衡
- 把同一个问题在多个模型上跑过,基于评估集做分数比较 (用数字而不是主观感受决定)
- 涉及个人信息或机密时,从 API 路径与保留策略反推选型
要点不是「先用最新模型再说」,而是 用评估数据来决定。
这个项目到底该不该上 RAG
其实在咨询里,我们也有一定比例会回复「这不是 RAG 项目」。判断轴很清楚。
- 数据规模在 几千字级别 → ❌ 直接放进 Prompt 更快也更准
- 数据 更新频繁 → ✅ 适合 RAG (无需再训练即可跟上)
- 检索精度 对业务至关重要 → ✅ 适合 RAG (用上述 2.0 方案)
- 需要 复杂的流程控制 → ❌ 单一 RAG 不够。需要 Agent 设计
如果不把这里弄清楚就贸然开工,会把不该用 RAG 解的问题硬塞给 RAG,到了运营阶段就只剩成本在烧 ── 这种悲剧时有发生。最初一周值得花在需求梳理上。
评估与运营 ── 不让项目止步于 PoC
RAG 不是做完就结束,做完之后才是正赛。我们在初期构建的同时,就把评估与运营的脚手架一并搭好。
- 问题 → 预期答案 → 预期来源 的评估集尽早整备
- Recall / Precision / 回答准确性的 持续性打分
- 文档新增、修订时的再索引流程纳入 CI
- 累积用户反馈 (👍 / 👎),回流到 Reranker 与检索参数的调整中
没有评估集就讨论「精度上不去」,只会原地打转。先把能用数字说话的状态建立起来,反而是最快的路。
也欢迎托付贵司的项目
RAG 是一个 光把库摆在一起精度也出不来 的领域。混合检索、Reranker、查询分解、状态管理 ── 哪些组合、哪些舍去,正是决定成果的判断。
我司以 LlamaIndex / Qdrant / bge-m3 为核心,一站式承接下一代 RAG 的构建、评估与运营。公司内部知识检索、客户应对的半自动化、规章与合同的 Q&A 平台等,「在我们的数据上真的有效吗?」 这一阶段就请来咨询。